
2月14日,在发布视频生成模型Seedance2.0之后,又发布图像创作模型Seedream5.0Lite,紧接着字节跳动发布了豆包大模型2.0系列。
据悉,豆包大模型2.0给出了Pro、Lite、Mini这三款不一样尺寸的通用Agent模型。此系列通用模型的多模态理解能力达成了全面的升级。并且还强化了LLM与Agent能力。使得模型在真实长链路任务当中能够稳定地去推进。还进一步将能力边界从竞赛级推理拓展到了研究级任务。
首次大版本跨代升级,数学推理和多模态理解能力突出
按照获得的讯息可得,豆包大模型2.0乃是由字节跳动最新推出来的多模态Agent模型呀,并且它还是豆包大模型自2024年5月正式发布之后首次出现的大版本的跨代升级呢。
在教育场景当中,大模型要理解图表、复杂文档、视频等内容,在娱乐场景之中也是如此,办公场景等众多场景里同样需要。对此,豆包2.0在多模态感知方面全面升级多模态理解能力,而且在高精度文字提取方面表现出色,在图表理解方面也表现出色,在空间理解方面表现出色,在运动理解方面,在视觉知识和推理方面,在长视频理解方面均表现出色。
身处动态场景之中,豆包2.0增进了针对时间序列以及运动感知的理解本领,并且能够达成实时视频流分析,以及环境感知和主动交互等功能,它被广泛运用于健身指导、穿搭建议、看护陪伴等一系列生活场景里。
有着丰富世界知识的大模型,执行长链路复杂任务,豆包 2.0 加强了长尾领域知识覆盖,于 SuperGPQA 等多项公开测试集上有着突出表现,其科学领域知识测试成绩和 Gemini3 Pro 以及 GPT5.2 不相上下,且在跨学科知识应用方面也位于前列。
豆包2.0 Pro在指令遵循、工具调用和SearchAgent等评测里达到顶级水平,这是其一;其二,在包含人类最后考试的HLE-Text上它还获得54.2的最高分,并且大幅领先于其他些许多模型;其三,Agent能力是大模型具备行动力的关键,测试成绩也显示了这点。
此外,豆包大模型2.0拥有更强的推理能力,它支持思考长度能够调节,并且在各个思考长度的情况下,Tokens效率都有了大幅度的提升,而模型的代码能力也有了显著的提升。
截至当下,豆包2.0 Pro于豆包App、电脑客户端以及网页版实现上线,用户选取“专家”模式便可展开对话体验。与此同时,火山引擎将豆包2.0系列模型API服务予以上线。
南方都市报旗下N视频的记者,运用豆包的专家模式,发送了一张林丹进行打球的图片,要求豆包对这个动作予以分析,并且提出能够改进的空间。豆包当场直接指出这乃是羽毛球领域传奇选手林丹的起跳杀球腾空准备动作,还针对此动作的核心优势以及可以优化进步的空间展开了分析。
南都的记者,运用豆包专家模式去测试了,测试的是近日在社交媒体上特别火爆的那个“洗车店离家五十米,究竟应该走路去还是开车去”的情况呵,豆包那里呢给出了三个场景相关的回复,要是情况是洗车的话,优先会让开车去,假如是车已经送去洗了并且完毕了、需要去取车的状况,优先就要走路去,要是只是去洗车店办卡、咨询之类的并非洗车才有的需求,优先也是走路去。
在豆包专家模式当中,补充了这样的信息,“冷车开50米伤车”这种说法完全是误区,还涵盖了极端天气之下的选择,以及特殊情况之下的选择。
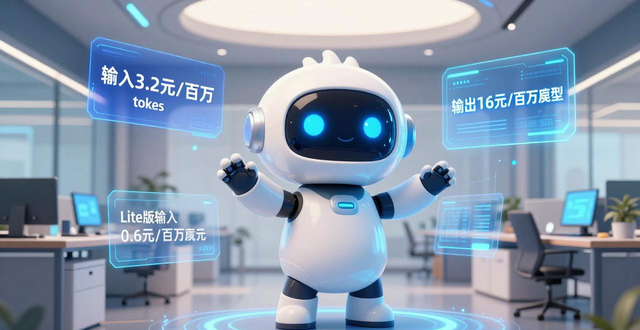
听闻,豆包2.0Pro依据“输入长度”的区间来确定价格,在32k以内的情况下,每百万tokens输入的定价是3.2元,而输出定价是16元/百万tokens,与Gemini3Pro以及GPT5.2相比较,有着较大的成本优势。豆包2.0Lite极具性价比,其综合性能超越了两个月之前发布的上一代主力模型豆包1.8,百万tokens输入价格仅仅为0.6元。
Seedance2.0外网爆火,有人帮老外充值赚钱
在2月12日的时候,生成豆包视频的模型Seedance2.0被接入到旗下的AI产品豆包以及即梦当中 ,当前用户能够在豆包APP里体验这个模型 ,也能在电脑端体验 ,还能在网页版体验 ,并且在即梦APP里体验 ,在即梦网页版等产品里同样能体验该模型。
其中,豆包 APP 支持真人出镜是一方面。即梦 APP 同样支持真人出镜,这是另一方面。用户要生成本人形象的数字人分身,得先通过录音录像完成真人校验才行,之后使用该分身生成 AI 视频。而在豆包电脑端、网页版以及即梦网页版等场景中,平台都明确提示暂不支持上传真人人脸素材,这是明确的规定。
南都记者于即梦App实测发觉,使用Seedance2.0要耗费相应积分,生成一段五秒视频需二十积分,积分获取途径有每日签到、购买会员或者充值;而在豆包App上线的Seedance2.0仅支持文生视频,暂时不支持图生视频,也无需积分,不过有生成额度限制,每个账号每日仅有十个额度,生成一段十秒视频要消耗两个额度。
网页端的Seedance2.0,能支持图像模态输入,能支持视频模态输入,能支持音频模态输入,能支持文本模态输入,这四种模态输入,使得表达方式更为丰富化,更使得生成变得更具可控性。用户可以借助一张图,来阐述自身想要的画面风格,用户可以运用一个视频,去指定角色的动作,去指定镜头的变化,用户可以采用一段音频,去传达预期的节奏,去传达预期的氛围,如此一来,“提示词”开始不再拘囿于文字,创作过程变得更为自然,变得更为高效,变得更像是真正的“导演”。
在这之前,Seedance2.0于小范围开展了内测,其在全球范围内引起了关注,埃隆·马斯克不禁发出感慨:“这发生起来实在是太快了。”有美国导演在试用Seedance2.0后发出感叹:“好莱坞可要走向覆灭了。”在海外社交平台上,不少国外用户,为了能够用上Seedance2.0,着手研究怎样申请中国手机号,还有网友帮国外用户充值积分以此来赚钱。
图像创作模型Seedream5.0发布,能理解模糊指令
2月13日发布的豆包图像创作模型Seedream5.0,和4.0版本比,在理解方面有提升,在推理方面有提升,在生成方面也有提升,它是个“更聪明”的视觉创意伙伴,还是个“更专业”的视觉创意伙伴。作为通向统一多模态模型的进一步探索,它开始能像人类设计师那样“理解”用户指令背后的意图,它开始能像人类设计师那样“看懂”不同画面中的规律,它还能将世界知识应用于图像与文本创作中。
据悉,Seedream5.0运用多模态理解生成统一架构,伴随跨模态理解与推理能力增强,不再有系统化那种精准的Prompt指令需求,它能够凭借简短且模糊的文本以及图像输入,主动去推测用户意图,与此同时,模型在主体一致性、图文对齐等生成这块的表现,也有着显著的进步。
再者,Seedream5.0当中内置着充裕的世界知识,这些知识涵盖了科技以及人文领域的多个细分行业知识库。在知识体系得到增强以后,它所生成的结果愈发契合物理规律,并且其信息可视化能力也有了极大幅度的提升。
实时检索致使“大脑”被冲破局限,Seedream模型优先引进实时检索强化能力,它能够借助联网检索方式,则能获取最为崭新的知识以及资讯,以相对更精准的状态应答具备时效性这类创作需求,特别适宜于资讯海报生成等场景。
当前,于即梦平台已然能够免费运用Seedream5。南都记者进行试用后发觉,运用Seedream模型并不必需积分,生成一张图片仅仅只需几秒钟时间,并且还能够领会模糊指令。
采写:南都N视频记者汪陈晨
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/279915.html

