
【ZOL中关村在线原创技术】AI技术迅猛发展, 应用生态也突飞猛进, 给人们工作, 给人们生活带来了深远影响。与此同时, 人们发现内存价格急剧上涨, 如同坐火箭一般, 完全打破了多年来“产能过剩、迭代降价、逐年亲民”的固有规律。随后, 手机纷纷减配或者涨价, 笔记本电脑纷纷减配或者涨价, 台式机DIY更是瞬间无人问津, 而这背后的元凶就是HBM内存。
HBM英文全称为High Bandwidth Memory, 也就是高带宽内存, 它是专门为AI训练以及高性能计算所产的高端存储产品, 从底层原理方面来看, 它仍旧是属于DRAM动态随机存取存储器的范围, 再看应用场景同样在此范畴, 不过它和我们电脑、手机里常用的DDR4、DDR5普通内存来源相同但形态不一样。比如说, 像下面图示里的NVIDIA H200, 它搭载的是HMB3e内存, 这内存呢, 是那种围绕着GPU核心的6个呈现方形的HBM晶片堆栈而成的, 并且它是和CPU一起并列着集成在同一个中介层, 也就是Interposer基板上面的。
就原理而言, 传统DDR内存所采用的是平面平铺样式的封装布局, 芯片引脚数量存在局限, 数据传输的通道宽度受到物理结构的约束, 传输速度也因物理结构受限, 容量提升困难, 性能提升同样困难, 一般仅能满足普通运算以及入门AI应用的需求。
而HBM对封装架构进行了革新, 它采用的是3D垂直堆叠工艺, 还搭配了TSV硅通孔技术, 把数十颗DRAM芯片垂直层层堆叠起来(是不是感觉挺熟悉呢), 之后通过微米级的精密硅通孔, 达成每一层芯片之间高速互联, 使传输距离更短, 还令信号损耗极低, 使得内存的数据吞吐能力实现量级跃升, 并且能防止GPU因需等待数据致使闲置, 它乃是AI芯片的核心配套资源。
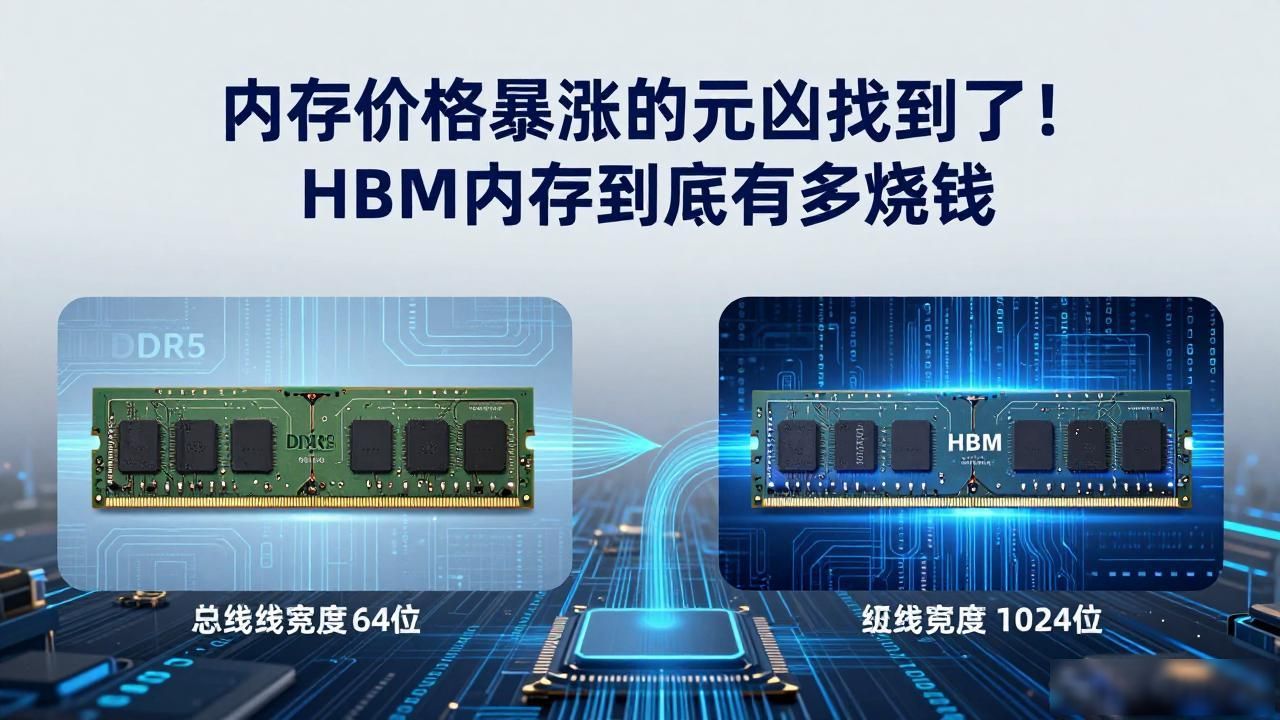
就性能而言, 每一堆HBM的总线宽度能够达到1024位, 甚至可以达到2048位, 然而普通的DDR5内存仅仅只有64位, 这就好比是从“乡间小道”升级成为了“高速公路”, 在单位时间之内能够传输的数据量呈现出数量级地增长。在带宽方面, 显卡上面的GDDR6内存仅仅拥有大约0.064TB/s的带宽, 可是HBM3e单堆栈带宽能够达到1.2TB/s, HBM4能够达到3.3TB/s以上, 其“供料速度”是GDDR的接近20倍。在容量方面。
能掌控存储市场定价情况的HBM, 其根本成因在于供需的不匹配以及产能的虹吸现象。自2023年全球AI行业全面迅猛发展以来, 为构筑AI算力中心、搭建算力集群, 对HBM内存产生的需求呈现出极为强劲的爆发式增长态势。与此同时, HBM内存的生产技艺壁垒异常之高, 市场的产能基本上完全被像SK海力士、美光等这样的存储巨头所占据垄断, 甚至连2026年、2027年的产能订单都已经全部销售一空, 这致使HBM内存的价格持续不断地急剧攀升, 单品所获取的利润率是普通DDR内存的数倍甚至会达到数十倍之多。
存储厂商为了能够抢占高端市场, 进而赚取高额利润, 纷纷对整体产能结构作出调整, 把核心产线、高端设备以及技术团队, 全部朝着HBM产品的研发和生产进行倾斜, 并且主动削减传统DDR内存产能, 这直接致使DDR供货量持续收紧, 其价格自然而然也就水涨船高, 而我们能够做到的, 除去努力赚钱以外也就只剩下等待这一选项了。
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/280645.html

