
2月7日,智东西报道,就在昨天,小米MiMo大模型团队宣称推出HySparse,这是一种针对Agent时代的混合稀疏注意力架构,它运用了一种核心设计,即“极少的全注意力(Full Attention)加上稀疏注意力(Sparse Attention)”。
在Agent模型跟应用呈现爆发式发展之际,精准且高效地处理超长文本正逐渐变成模型不可或缺的基础能力,Agent不但得于超长上下文里达成稳定检索、推理以及多轮规划,还务必在推理阶段维持足够快的响应速度,当前最大的挑战已并非只是“能不能算”,而是“算不算得起”。
因此,小米MiMo推出了HySparse架构,在诸多通用评测中,HySparse带来提升,在数学评测里,HySparse带来提升,在代码评测方面,HySparse带来提升,在中文评测当中,HySparse在7B Dense规模带来提升,在80B MoE规模也带来提升。
当中,于总计49层的80B - A3B MoE模型开展的实验里,HySparse仅仅留存5层Full Attention,却依旧能够维持或者提升模型的能力,KV Cache存储降至原本的1/11,达成了效果与效率两者的兼顾。
RULER进行长文测试得出结果,HySparse就算把Full Attention层压缩到非常少的数量,依然能够稳定地维持对长距离关键信息的访问,这显示出了它混合稀疏结构所具备的优势。
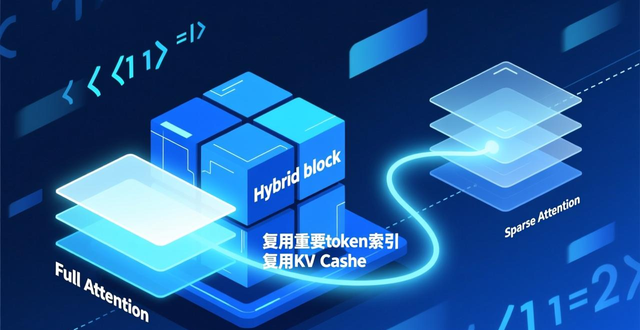
HySparse运用hybrid block结构,其中,每个hybrid block是由1层Full Attention加上N层Sparse Attention所构成的。Hybrid block内部的Sparse Attention层,并非再单独去做token选择以及维护全量KV,而是直接去复用前置Full Attention层所产生的重要token索引以及KV Cache。
背后的这个动机,在于Full Attention,它在完成自身那项计算的时候,已然生成了KV Cache,而且还计算出了最为准确的token重要性信息,如此一来,自然而然地便可以供后续的N个Sparse Attention层直接去复用。
可以将HySparse看作是,先是基于MiMo-V2-Flash的Hybrid SWA结构,然后为SWA增添了全局的、更为重要的token信息补充。这样的一种改进,不但提升了性能,而且没有增加KV Cache存储,并且也没有显著加大计算开销。
在Agent这个时代阶段里,HySparse结构针对超长文本处理这一情况,给出可实现高效精准效果的技术解决办法,并且,它还为大模型高效注意力结构的研究以及落地,提供了全新的一种参考依据。
小米MiMo透露,团队有这样的计划,要在规模更大的模型之上,进一步去验证HySparse的极限以及潜力,并且持续不断地探索降低Full Attention层数量的那种可能性,能够让超长上下文达成更为高效的效果。
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/279911.html

