
现今的AI agent常会把长交互历史直接保存下来,然而却很难进行高效的复用,最质朴的办法是直接从「原始记忆」当中去检索,可却常常会让模型身陷冗长且低价值的上下文之中,PlugMem将经验转化成结构化、可以复用的知识,并且提出了一个任务无关的统一记忆模块,在多种Agent基准上提高性能,同时消耗更少。
随着AI agent去承担那些越发复杂起来的任务,这些任务包含长对话、多步推理、交互式网页导航等等,它们就必须要记住并且复用过往的经验。
但是,大多数现有的记忆系统,更类似于「日志文件」,它会持续不断地累积原始交互轨迹,在需要的时候,再从其中取出某些文本片段。随着时间的推移,记忆会无休止地增长、噪声不断增多,并且会快速地挤占agent的上下文窗口。
于是,一个悖论出现了,AI agent有着前所未有的「记忆量」,可却依旧难以有效地去使用。然而,对于决策真正重要的那些内容,常常并不是完整的交互记录,而是从记录里沉淀出来的知识。
比如说,当进行商品推荐之际,agent要记住用户的偏好,而非反复去阅读冗长的对话;在新网站进行购物之时,agent所需要的是那种「怎样搜索、如何筛选、怎样下单」的通用策略,并非重放自己曾经看过的每一个页面。
有着记忆问题的核心挑战的AI agent,并非是「存更多」,而是要以一种能够突出决策相关信息的方式来组织记忆。
UIUC、清华大学最新推举出的AI agent的记忆方式PlugMem显现,这个记忆方式乃一个与诸多任务均无关联、乃是即插即用型的记忆模块,其作用在于把智能体原本的经验转变成能够再度使用的知识。PlugMem并没有像常规那样将其对待记忆的方式设定为以扁平文本形式去检索,而是参照认知科学领域的相关理念做法,把经验去结构化为一种以知识作为核心要点的表示形式。
论文的链接是,https://arxiv.org/abs/2603.03296,这样子。
代码的链接是, https://github.com/TIMAN-group/PlugMem , 这样的一个链接。
认知科学常常区分出三类记忆,分别是:对于事件的回想,对于事实的认知,以及对于技能或者策略的把握。事件能够提供背景,然而有效决策却是依赖于从事件里抽象出来的事实以及技能。这样的一个视角给予我们启发,促使我们重新去思索AI agent的记忆设计。
将对话、文档、网页轨迹等异构交互记录转化为结构化知识单元的PlugMem,具备更紧凑、更可复用的特点,而且与决策直接对齐。
PlugMem包含三个核心组件:
结构化,它会把原始情景经验予以标准化,进而提取成两类知识,一类是命题式知识,也就是事实,另一类是处方式知识,即可复用技能或者策略。这些知识单元被组织成结构化的记忆图。
不再对变长文本块进行检索,而是去检索和当前任务语义相匹配的知识单元,高层概念以及意图当作「路由信号」,助力迅速定位最为有关联的内容,这里有个信息是Retrieval(检索)。
历经推理,将检索所得知识予以深化压缩,使之转化成简洁且能够直接运用于当下任务的指引,随后交付给AI agent以供使用,借此更为高效地借助上下文。
把异构智能体经验,经由PlugMem组织成知识中心的记忆图,达成结构化检索还有推理。
传统GraphRAG系统跟PlugMem的关键不同之处在于「记忆访问单元」,传统办法一般索引文本chunk或者实体,PlugMem把知识单元(命题与处方)当作基本构件,如此这般的设计降低了冗余,提升了信息密度,还提高了检索精度。
一个能跨任务迁移的记忆模块
很多记忆系统常常是针对特定基准特意去精心定制的,比如说对话记忆,还有知识密集问答,以及网页智能体等等。这类任务特定的记忆模块在单个场景当中或许表现会很不错,然而一旦更换任务,往往就需要重新去进行设计。
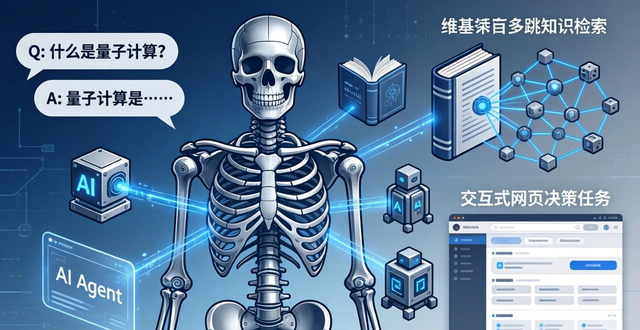
PlugMem采用了别样方式,它身为即插即用的通用记忆骨架,能够径直连到各异的AI agent上,无需针对任务开展专门性修改。文中借助相同模块,维持实现不变,于三个异构基准下评测,分别是长程对话式问答,以及基于维基百科的多跳知识检索,还有交互式网页决策任务。
结果呈现出这样的情况,即PlugMem于三种设定情形之下,均稳定地使得任务表现得以提高,其程度超越了通用的检索方式以及多种任务针对的记忆设计。更为关键的是,这些提升达成的前提是,向AI agent上下文注入的记忆智元(token)显著更少。
用「效用」衡量记忆
而不是用「大小」
仅凭借任务准确率,不能够展现记忆系统的核心能力,记忆模块存在着这样的情况,它所要做的是,得在“决策效用”以及“上下文成本”之间,进行利弊权衡,这是必然的。
所以,在PlugMem的工作开展进程里,提出了一项信息论方面的指标,依靠这个指标去衡量记忆系统,每消耗掉一个智元(token),究竟能够带来多少与「决策相关的信息增益」。从直观层面来讲,记忆模块所产生的记忆智元(token),会使AI agent对于正确行动的把握度能提升多少呢?随后,再依据记忆长度进行归一化处理。
在效用与成本所构成的空间当中,PlugMem稳定地处于具备更显著优势的位置,即,在更低的智元也就是token成本的情形下,能够获取到更高的决策效用。
在多种基准当中,PlugMem做到了在更小的记忆预算情形下,去提供更高的与决策相关的效用。
这些结果支持这样一个结论,将经验转化为知识,相较于直接检索原始日志,更为紧凑,更具信息量。
超过任务特定设计
一开始看的时候,会觉得,一个和任务没有关系的记忆模块,居然能够比专门为某个基准去量身打造的方法还要强,这事好像有点违背直观感受。PlugMem得出的结果显示,起决定作用的因素,常常不是针对特定benchmark的那些启发式的技巧,而是对于「和决策相关的知识抽取」的有效检索。
没有进行检索的话,记忆仅仅是处于静态的存储状态;要是不存在结构化知识,那么检索会缺少精度。PlugMem把以下三件事情予以拆开并且协同合作:结构化断定「什么样的内容是能够被检索的」,检索判定「记忆是不是真的能够对决策起到帮助」,推理/压缩保证「以更低的成本被AI智能体加以利用」。
PlugMem并不尝试去替代任务特定技巧,它更像是一个具有通用性的记忆底座,在其上层依旧能够进行任务适配的叠加,有实验表明,在PlugMem的基础之上再增添任务特定启发式探索方法,通常还能够进一步提高效果,二者具备互补性。
走向智能体的「可复用知识基础设施」
随着AI agent朝着具备更长程自主能力的方向发展,记忆不能再仅仅局限于被动存储,而要演变成一种主动型的知识基础设施,agents需要积累那些能够进行迁移的事实以及应用策略,以此实现知识在不同任务、不同环境下的重复使用,进而减轻AI agents冷启动时所面临的问题,并且为更强的泛化能力提供支撑。
PlugMem朝着这个方向跨出了一步,它从认知科学那里获取设计灵感,把「知识」当作复用的基本单元,呈现出任务无关记忆在效率以及能力方面同时具备可行性。
换一种更具广义性的视角来看,此项工作所提示出来的是这样一种视角方面的转变,即并非去追求更多上下文内容的检索,与之相反的是要去追求将经验以一种天然就具备可复用特性的形式予以呈现。伴随智能体能力不断地扩展,能够实现可扩展以及可迁移的记忆系统将会变成基础设施;以知识为中心构建起来的记忆极有可能会成为下一代智能体的关键基石。
参考资料:
这是一个链接,链接内容为https://arxiv.org/abs/2603.03296。
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/280107.html

