
凌晨时分,谷歌DeepMind的首席执行官名为德米斯·哈萨比斯的人,在X之上发布了四颗钻石所构成的表情符号,那种神秘感被充分地拉满了。
几小时之后,谜底得以揭晓,谷歌正式发布了 Gemma 4 系列,该系列包含 E2B、E4B、26B - A4B、31B 这 4 种型号,这一系列属于他们截至目前最为强大的开源模型家族类型。
格外让人意想不到的是,这一回谷歌完全放下了架子,径直采用了Apache 2.0开源协议。需明确,此前Gemma 3那一套自定义协议,开发者们可是整整抱怨了一年。
阅毕发布内容,之感此言不虚,此次谷歌若说并非真切在致力于那开源模型之上费尽心力行事者,则大错特错误见之论是也。31B版本然决然直接攀升至Arena AI 排行榜的全球第三之阶位,单凭不足十分之一量级的参数量,居然得以对抗具备400亿参数那般堪称庞然大物般的模型,与之相较量而毫不逊色。如此这般参数效率的显著提升,对于那些意图于本地运行模型之人来讲,其意义之重大,实乃超越世间一切事物也。
Gemma 4与国产大模型跑分对比
最大的 Gemma 4 亮点技术,是它直接继承了 Gemini 3 的技术架构以及研究成果。谷歌在官方博客里说得很明白,其表示“Gemma 4 是基于与 Gemini 3 相同的世界级技术以及研究打造”。这意味着什么呢?那就是谷歌把自家闭源旗舰模型的核心能力,下放至开源模型上了。
这种所谓的“技术下放”,于大厂之中实际上并不常见。一般而言,闭源模型与开源模型属于两条全然不同的技术路线,然而谷歌此次却作出选择,让 Gemma 4 与 Gemini 3 共享底层技术,这恰也解释了为何 Gemma 4 的性能提升得如此显著。
丨小身材,大能量:31B 击败 397B 巨无霸
实际上,于正式发布以前,社区当中就已然有人察觉到了相关风声。在LMSYS Chatbot Arena之上突然间涌现出了一个代号称作“significant-otter”的匿名模型,有用户带着好奇之心询问它究竟是谁,它径直给出回答:“I am Gemma 4, a large language model developed by Google DeepMind。”。
Reddit上,r/LocalLLaMA社区当中的用户进行了反馈,阐述这个模型的响应速度快到相当吓人的程度,并且它并非属于那种专门致力于搞推理的模型,同时基础能力测试全部都通过了。
那四颗钻石emoji的Hassabis,是在暗示Gemma 4的四个版本,这位DeepMind的掌门人,在发布会上直接放话,这是全球同等规模下最好的开源模型。
最令人感到震惊的是,Gemma 4 31B 的实际展现情况。于业界标准的 Arena AI 文本排行榜里,31B Dense 版本径直冲到了全球开源模型的第三名,仅仅次于 GLM-5 和 Kimi 2.5 这两者,并且 26B MoE 版本位列第六。这究竟意味着什么呢?它们战胜了数量众多的,参数量是自身 20 倍的巨型模型。
需明白,像Qwen 3.5 397B这般级别的模型,其参数量将近400亿,与Gemini 3 Pro、Claude Opus 4.5、GPT - 5.2处于同一性能档次。然而,Gemma 4 31B仅用不到十分之一的参数量,便能够在排行榜上和这些庞然大物一较高下。谷歌将此称作“每参数智能”,也就是凭借更少的参数,达成更高的性能。
依据实测数据而言,Gemma 4 31B在诸多关键测试里成就夺目。于MMLU Pro这项测试中,拿下了百分之八十五点二的成绩。针对于AIME 2026数学竞赛题目,达成了百分之八十九点二的准确率。在LiveCodeBench v6代码测试里,获得了百分之八十点零的结果。于Codeforces编程竞赛ELO评分方面,高达两千一百五十。
需清楚,上一代的情况来讲,Gemma 3 27B,于AIME 2026这个事件上,仅仅占据着20.8%,然而此次明显达到了四倍还要多的程度,是其直接的上涨变化。
更为夸张的是,视觉以及多模态能力,在MMMU Pro多模态理解测试里,31B版本取得了76.9%的成绩,在MATH-Vision数学视觉题目中为85.6%,医学图像评估MedXpertQA MM达到了61.3%,就连音频处理能力也未曾落后,E4B和E2B这两个移动端版本,在CoVoST语音翻译测试中,分别获得了35.54和33.47的分数。
此等参数效率的提高变化,针对那些想要于本地运行模型之人而言,有着相当重要的意义价值。你无需耗费几万块去购置一张H100,凭借一张消费级的显卡,便可为接近顶尖的性能提供运行条件。
丨从手机到工作站,四个版本各有所长
Gemma 4 这次发布了四个版本,从手机到服务器全覆盖。
专门为移动设备设计的最小的Effective 2B(E2B)和Effective 4B(E4B),在你的Android手机上能够完全离线运行,甚至在树莓派上均可运行,谷歌与Pixel团队、高通、联发科共同合作进行优化,延迟几乎为零。
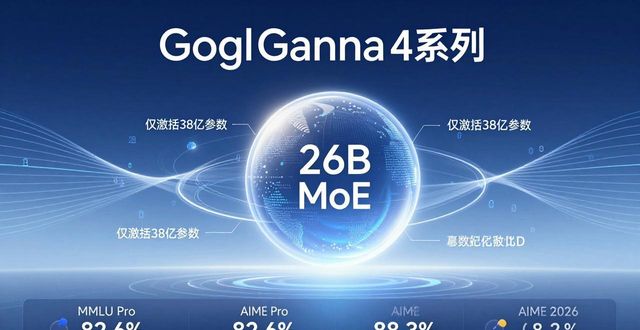
对26B的MoE也就是混合专家版本来说,则更具趣味,它尽管有着260亿参数,可是在进行推理之时,仅仅激活38亿参数,这表明其速度快得惊人,每秒生成的token数量相较于同等规模的模型要高出许多。在MMLU Pro上取得了82.6%的成绩,在AIME 2026中达到了88.3%,与31B版本咬得相当紧,然而推理速度却快了太多。
追求极致质量的是 31B Dense 版本,据谷歌所说,这般做是为了能够让开发者在其上开展精细化微调。于 GPQA Diamond 科学推理测试里取得的成绩是 84.3%,Tau2 综合测试平均成绩为 76.9%,BigBench Extra Hard 超难任务的成绩是 74.4%。将这些分数置于开源模型当中,已然属于顶尖水平了。
每个版本皆原生支援视频,以及图像输入,具备进行OCR和图表理解的能力。E2B与E4B,同样支持原生音频输入,可开展语音识别与理解工作。更为夸张之处在于,Gemma 4原生就训练用于140多种语言,上下文窗口边缘模型存在12.8万token,大模型拥有25.6万token。
丨Apache 2.0:谷歌终于听进去了开发者的抱怨
倘若讲性能的提升属于意料之内的情况,那么协议的变更便是实实在在的惊喜所在了。先前 Gemma 3 所采用的是谷歌自身定制的协议,其中存在着一连串的限制条款,谷歌能够单方面随时去修改使用规则,开发者必须于所有基于 Gemma 的项目当中执行谷歌的规定。有些条款甚至能够被解读成,要是你借助 Gemma 生成了合成数据,这个协议还能够延伸至你运用这些数据训练的其他 AI 模型之上。这使得众多开发者对于使用谷歌的开源模型心怀顾虑。
此次,Gemma 4 径直替换成了 Apache 2.0 协议,此乃业界极为宽松、特别成熟的开源协议当中的一个,不存在那些过度进行限制的使用条文,不存在商业方面的限制,即为如谷歌哪天忽然宣称协议要更改就更改是不行的,开发者们对这个协议熟悉,运用起来会感到放心,谷歌于官方博客之中表明 “你们给予了我们反馈,我们将回馈接纳了进去,构造AI的未来需借助协作,我们坚信应当向开发者生态赋予能力,而不是去设置具有限制性质的阻碍。”。
“Gemmaverse”已然成型,其有着4亿次下载量,还有10万个变体。
第一代 Gemma 于 2024 年 2 月发布,自那以后,开发者们下载次数已超 4 亿次,社区创造了超 10 万个变体。谷歌将此称作“Gemmaverse”,即一个围绕 Gemma 构建而成的生态宇宙。
有些变体相当有意思,这些变体里。比如,MedGemma这样一个基于Gemma 3做的医疗影像和报告生成工具。还有,DolphinGemma用于 分析海豚的声音。另外,做手语翻译的叫SignGemma。可见,这些应用远远超出了通用聊天的范畴,证明了开源模型架构的潜力。
在Reddit上,有开发者对Gemma 27B和其他同规模模型做了对比,他讲,Mistral 24B的微调版本,和Gemma 27B,大概在10 - 20%的时候,能够赢过Qwen 27B,然而,80 - 90%的时候,仍旧是Qwen更强。不过,Gemma在长上下文能力方面的表现,真的是很出色的。这回,在长上下文测试MRCR v2这件事上,Gemma 4,31B版本拿来了66.4%,相较于上一代的13.5%,提升幅度达到了整整五倍之众。
丨本地 AI 的野心:不联网也能用上顶级智能
Gemma 4 的最大意义,实际上是将“本地 AI”这件事提升到了新的高度,你能够在自己的硬件上运行这些模型,无需连接云端,不必担忧隐私泄露,并且也不用为每次 API 调用支付费用。
谷歌于开发者博客之上表述得极为明晰:“Gemma 4 将你于自身硬件之上所能达成之事予以重新界定。当下,你能够跨越聊天机器人范畴,构筑可于设备之上径直运行的智能体以及自主 AI 应用。”Android 开发者能够借由全新的 AICore Developer Preview 去访问内置的 Gemma 4 模型,抑或以 Google AI Edge 在移动端、桌面端以及边缘设备上搭建智能体应用。
Arm公司加以体现,于其新闻稿之中也予以阐明,Gemma 4针对依循Arm架构的Android设备实施了深度层面的优化举措,只要开发者是面向凭借SME2特性研制而成的Arm系列设备,那么便能够自动收获到开箱之后即可运用的性能优化成果。用户能够切实感受到较为快速的响应效果,能够体察得知较为流畅丝毫未被打断持续交互成果,能够领略到更具可靠性质的设备端AI实际表现,亦能够与此同时维持电池续航方面以及散热方面的稳定状态。
丨开源模型的战场,谷歌不想输给中国
Gemma 4 的发布,实际上反映出了一个更大的背景情况,美国处于开源大语言模型领域,相较于中国而言已经落后了,中国的 DeepSeek、Qwen 这些开源模型在全球范围内得到了大量关注并且被使用,英伟达同样在推行 Nemotron 系列以此来发展开源 AI 生态,谷歌明显不想在这个竞争场中缺席。
对企业而言,开源模型的价值体现于能够依照具体业务场景予以定制,谷歌表明Gemma已然拥有超过10万个变体,该数字自身便证实了需求的蓬勃旺盛。虽OpenRouter使用数据表明,谷歌开源模型于实际部署中一直落后于Meta的LLaMA以及DeepSeek,然而Gemma 4此次融合了具竞争力的基准测试性能、Apache 2.0协议还有强大的移动端优先工程,或许会比以往任何一代Gemma都更具说服力。
丨从现在开始就能用上
Gemma 4 已在 Google AI Studio(31B 和 26B MoE)上线,同时也在 Google AI Edge Gallery(E4B 和 E2B)上线了。你能够从 Hugging Face、Kaggle、Ollama 下载模型权重。首日便支持 vLLM、llama.cpp、MLX、NVIDIA NIM 等平台。
谷歌发布了一个新的 Python 包以及 CLI 工具 litert-lm,它能让开发者在控制台里直接体验 Gemma,且无需编写任何代码,此CLI支持 Linux,支持 macOS,还支持树莓派,现在它又支持工具调用功能。
德米斯·哈萨比斯在发布之际所讲的那番话语,或许极有可能最为恰当地归纳 Gemma 4 的定位,那便是:“以字节来进行计算,这属于全球范围内最为强劲的开源模型。”谷歌此次确实是真心实意地打算在开源 AI 这条赛道之上认真地跑一跑了。
全面解读:Google Gemma 4开源
谷歌声称发布了 Gemma 4 这款开源的,具备 31B 参数且性能能够达到头部水准的大模型。
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/280173.html

