
https://github.com/MoonshotAI/Kimi-K3/blob/main/k3_tech_report.pdf
技术博客地址:
这是一个网址链接, 它是https开头的, 具体是https://www.kimi.com/blog/kimi-k3。
01.
2.8亿参数模型权重全面开放
三大关键Infra技术开源
Kimi K3, 是个有着2.8万亿参数的混合专家模型, 它具备原生视觉理解能力, 还支持100万token的上下文窗口。
如今, 每一个人都能够去下载, 并且能够进行部署Kimi K3模型, 不管是将其用于内部展开研发, 还是嵌入到面向终端用户的产品里面, 都能够自由地去使用。
此次, Kimi K3同步开源了训练系统, 该训练系统是Infra基础设施层的三项Infra技术, 分别是MoonEP、FlashKDA以及AgentEnv。
在三项开源的Infra技术里边, MoonEP是一款针对超大细粒度MoE打造的高性能通信库, 它能使专家并行通信于不均衡状况下依旧维持极致效率。
FlashKDA这般高性能算子是Kimi Delta Attention, 其在英伟达H20那儿的prefill速度跟闪线注意力基线比起来提升了1.72至2.22倍, 它能够直接当作替换后端进行使用。
AgentEnv这个沙箱系统, 是跟KVCache.ai合作搞出来的, 它能给大规模Agent训练提供既高保真又强隔离的运行环境, 还支持快速快照、恢复以及分叉, 能够应对大规模并行的Agent工作流。这里面, FlashKDA以前就已经开源了, MoonEP和AgentEnv是随着这次发布才正式开源的。
针对模型架构而言, KDA+AttnRes将KDA跟Gated MLA依照3:1的比例予以混合, 运用块级注意力残差促使跨层信息流动得以增强, 达成高效长上下文建模。
每一个token, 由Stable LatentMoE从896个路由专家里激活16个, 借助SiTU - GLU以及Quantile Balancing, 于极高稀疏度状况下维持训练的稳定。
MoonViT-V2视觉编码器, 采用从零开始的方式, 运用next-token prediction进行训练, 不借助对比预训练, 在达成基线效果之际, 获取更为稳定的优化进程。
于后训练这一方面, 模型在通用推理这个领域, 以及通用Agent这个领域, 还有编程Agent这个领域, 开展大规模任务合成, 协同百万token上下文的强化学习基建, 并且完成了将近20个内部评测集的完整评估。
02.
多维评测
验证编程、Agent与视觉能力全面提升
在官方所公布的评测结果里头, Kimi K3于编程这个方向, 展现出较强能力, 在Agent任务这个方向, 也展现出较强能力, 在视觉理解这个方向, 同样展现出较强能力。
论到编程能力这块, Kimi K3于超长时序持续开展的SWE Marathon测试里, 表现卓越, 在软件逆向的Program Bench测试中, 展现出色, 于终端运维的Terminal Bench 2.1测试当中, 成果显著。
其中, SWE Marathon取得第一名, Program Bench同样拿到第一, Terminal Bench 2.1获得了88.3分, 该分数与GPT - 5.6 Sol较为接近;在高难度的软件工程任务FrontierSWE里, Kimi K3以81.2分的成绩位居第二, 仅仅次于Claude Fable 5。
于Agent及知识工作场景当中, Kimi K3同样呈现出较强的任务执行能力, 于网页深度调研BrowseComp测试获取佳绩, 于办公自动化Automation Bench测试勇夺榜首, 于Excel财务建模SpreadsheetBench 2测试名列前茅, 其中BrowseComp测试分数达91.2分, Automation Bench测试排名首位, SpreadsheetBench 2测试亦排名榜首。
然而, 于综合白领任务GDPval - AA v2、APEX - Agents这般更贴近于真实办公流程的评测里面, Kimi K3依旧比Claude Fable 5等顶级闭源模型要弱。
从视觉能力来讲, Kimi K3于图表理解CharXiv、文档分析OmniDocBench等任务里, 展现出较强的表现, 当中OmniDocBench取得91.1分,超越了参与对比的好多款模型, 然而在部分视觉推理任务中, Kimi K3依旧存在差距, 就像零样本视觉工具任务Zerobench比Claude Fable 5低。
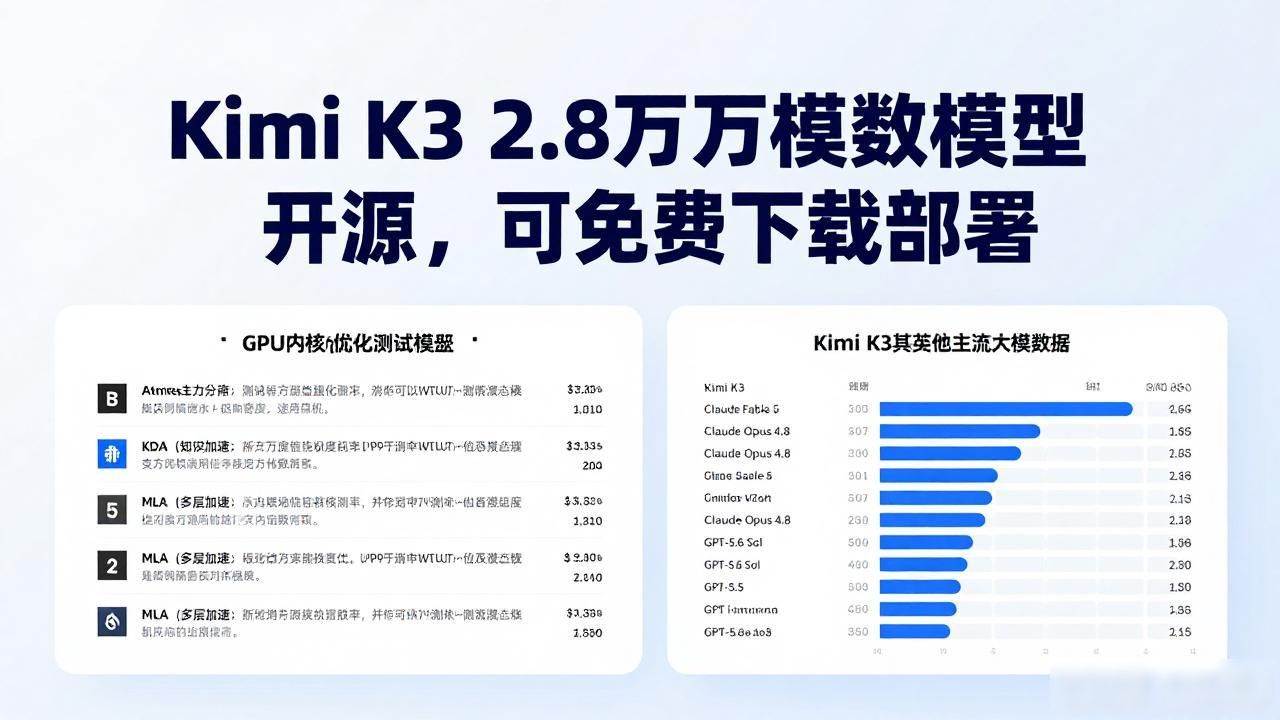
Kimi里头也对Kimi K3的工程能力做了测试。于GPU内核优化测试当中, Kimi K3得自行完成代码分析呢, 还有内核重写, 跟着进行性能验证。这覆盖了诸如AttnRes、KDA、MLA等GPU计算任务。结果表明, 处于最高推理强度的状况下, Kimi K3的表现跟Claude Fable 5(包含回退机制)相近, 并且超越了Claude Opus 4.8、GPT-5.6 Sol以及GPT-5.5。
于知识工作范畴, Kimi内部的Internal Knowledge Work Bench测试表明, 当统一开启最高深度思考模式之时, Kimi K3于通用推理、深度文档分析以及金融专项这三类任务里的表现, 皆凌驾于GPT - 5.5以及Claude Opus 4.8之上。
03.
Kimi K3挑战复杂任务:
生成游戏、设计芯片、分析科研数据
科米K3发布之后, 智东西于科米K3的马克斯模式下面, 对该模型那多模态以及代码生成的能力开展实际测试, 在提出生成3D横版格斗游戏这般要求的测试里, 提示词涵盖关于“被霸天虎入侵的破败城市地图”、“低多边形风格”、“5种擎天柱阵营角色”、“5种霸天虎变种敌人”的复杂设定, 科米X3光是使用一次就达成了游戏创建, 没有出现错误情况且。
在游戏设计的场景之中, 海外开发者@He1s_Sammy针对Kimi K3、GPT - 5.6 Sol以及Fable 5这三款模型展开了对比测试, 给这三款模型输入的提示词乃是完全一样的, 从方案质量、游玩体验以及调用成本这几个方面进行综合评估。
有测试结果表明, Kimi K3在游戏设计这方面作出的呈现是表现最为出色的, 它可以精准抓住玩法的核心要点, 所产出的内容其节奏显得自然而然;然而, Fable 5同GPT - 5.6 Sol生成的游戏, 它们的节奏通常来讲是过快的。
价格方面, Kimi K3的评分是9.5/10, 其调用成本为0.030美元, 换算成人民币约0.2元 , Fable 5的评分是7.5/10, 调用成本是0.38美元(约合人民币2.57元), GPT-5.6 Sol的评分是7/10, 调用成本为0.11美元(约合人民币0.73元)。
于官方所展示的案例里, Kimi K3呈现出了更具长程性质的任务执行能力, 在芯片设计这一方面, K3是依据开源EDA工具以及Nangate 45nm工艺库的, 在历经48小时的连续自主运行期间, 独立自主地达成了芯片的构建、优化以及验证。
针对科研范畴, K3开展处理, 一下分析多达391个GWTC - 5引力波事件, 调用20多个并列从属智能个体, 生成7张以可视方式所呈现的科学成果图形, 给出两张表状物, 并且对10多篇具有参考作用的论文所涵盖内容予以整合。
它在GPU编程领域, 从无到有开发了类似Triton的编译器MiniTriton, 能把开发者所编写的程序, 转化成GPU可执行的代码, 在部分场景里, 其性能甚至比现有工具还要强。
04.
结语:中国开源模型
正在进入全球开发者的工具箱
对于叫Kimi K3的这个, 海外开发者的反应跟半年往昔已然存有显著差异了。半年之前, 当DeepSeek-V3进行开源之际, 海外社区之中的讨论较多呈现为“又一个源自中国的模型”这般情形。然而到了Kimi K3出现之时, 相关话题已然转变成为“它在性能方面比Claude Opus更为强劲”、“开发者正着手将Fable置换成K3”。
影响力有所增大, 这也就表明被盯上的风险同样在提升, 在Kimi K3开源致使引发热议之际, 美国参议员蒂姆·斯科特以及比尔·哈格蒂已然提出议案来扩充商务部权限, 以此去限制外国对手接触AI技术, 美国商务部于去年就曾思索把月之暗面、DeepSeek、阿里Qwen团队等中国AI实验室列入实体清单, 白宫也曾考量借助行政令, 要求运用中国模型的美国企业对安全事件担负责任。美国的闭源AI企业, 像OpenAI、Anthropic这些, 曾经提出了要禁止使用中国开源模型的提案。
回应的是商务部, 称这是“典型的人工智能霸权主义行径”, 还指出有近200家美国初创企业, 它们敦促政府不要切断对中国开源模型的访问, 因为这些企业觉得这么做会削弱自身竞争力。
当在美国开展业务的企业自身所使用的都是来于中国的开源的模型之时, 那么针对相关行为进行制裁所具备的合理性从而显然站立已经不住就脚了。人工智能所拥有的能力正在从属于少数公司所具备的技术方面的优势, 进而转变成为全球范围内的开发者能够进行调用的基础性工具, 而这样的一种趋势是不会因为仅仅的一纸制裁命令就发生改变的。
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/280642.html

