
文 观察者网心智观察所
在3月里的某一个属于工作日的日子,于深圳南山区那座腾讯总部大厦的北广场之处,出现了排起长队的情况。
有人怀抱着NAS,有人手提迷你主机,还有人拿出MacBook,他们是要来叫腾讯的工程师帮助其装机一个个名为OpenClaw的开源AI智能家伙的情况。预约号在上午11点的时候就被抢购一空了,队伍当中存在程序员,也有小学生。在抖音之上,“全民养龙虾”的短视频广泛传播而占有了大量位置了。目前场景极其类似十年之前安卓刷机的极客集会,然而又并非完全相同,这次中,普通的民众人也夹杂进来了。
当下所见这般情形,并非是那家名为腾讯的企业于开展一场行为艺术范畴之事。于此相同的时刻,名为阿里的公司在推行“OpenClaw一键上云”这一举措,而小米对外公开宣告要把自身所拥有的MiclawAgent安置进手机、汽车以及电视等各类产品之中,智谱、MiniMax这类模型制造厂商同样纷纷迅速跟进。OpenClaw在GitHub这个平台上获得标志,在此短短只有三周的时间内,数量急剧增长突破了25万,这一数据超越了像Linux那样历经三十年才积累而成的成果。一个无法回避、必然会出现的问题冒了出来:究竟缘何是在当前这个时候?到底是因何原因才会出现在中国这个地方?为什么所有那些处于行业领先地位具有极大影响力的企业都表现得如此急切?
一台永不停歇的算力抽水机
需弄明白这场名为“龙虾风暴”的究竟在刮些什么,那就得先瞧瞧一组会让人睡不着觉的数字。
2026年,字节、阿里、腾讯这三家,加起来预计要花费超过600亿美元,其中绝大部分都砸向了算力。成千上万张AI加速卡被拉进了数据中心,然而要是没人调用,它们每天就在那儿烧钱。它们是沉默的、正在燃烧现金的机器。
整整过去两年之久,大模型当时主要在进行主打“聊天”的玩法:时不时间你将其用于写一封邮件,或者画一张图片,所消耗的Token数量极为稀少。这么轻微程度的使用方式,根本就没办法填满那些算力集群在运营方面所需的成本之处,更不要提及想要从习惯免费使用的普通用户那里获取利润了,巨头们急切地需要一个能够持久、自动地消耗算力的所谓“Token黑洞”。
OpenClaw,恰好契合了这般需求。你赋予它一条复杂指令,它并非仅仅回复你一段话语,而是会拆解任务,连接网络进行搜索,调用软件,检查错误,重新尝试——每一个步骤都要向云端发送请求。运行完一个复杂任务,Token的消耗数量是普通对话的百倍甚至于千倍。
有AI行业分析师告知心智观察所,国产模型被OpenClaw大量运用,其核心缘故是性价比,即比海外便宜许多,调用时不会心疼。因便宜,进而直接转变为更高频率的调用,以及更可观的现金流。
这便能够做出解释,为何腾讯甘愿投入人力去线下“摆摊”。每次进行部署,都是于用户的电脑或者云端之中,埋下一台持续不断運转二十四个小时的“算力抽水机”。无论前端运行的是何种模型,只要推理以及工具调用的API指向自家云服务,那些细微的请求,最终都会汇聚成为实实在在的金钱。
经心智观察所绘制的,有关OpenClaw的,关键发展进程里的重要标志节点和功能随时间推进而产生变化的展示图,(@心智标签为制图)
一组更直观的数据能帮我们理解这波操作的经济账。
身为OpenClaw的重度使用者,每日Token的消耗数量处于3000万至1亿的范围之内。要是借助Claude Opus 4.6来计算,一日所需费用在900至3000美元的区间;就是采用国产的MiniMax M2.5,也得花费42到140美元。这一费用额度远远超越了GPT那种对话场景——在后者那里月费仅仅20美元,然而一个处于活跃状态的OpenClaw实例,一天就能消耗掉百倍于此数的Token。
若未来的一两年当中,存在100万个OpenClaw实例成功实现商业模型的运行,哪怕仅仅是刚好达到回本的状态,便会新增大约3600亿美元的Agentic AI算力市场。这个表示数量的数字,足够对整个半导体产业链的供需格局进行重塑。也就是说,AI的商业变现途径,并非依靠“让更多的人展开聊天”,而是借助“让更少的Agent持续进行任务执行”。Token经济学的底层所蕴含的逻辑,正从频率较低、数量较少的人机对话,朝着频率较高、数量较多的机器自主执行方向转变。
数据饥渴:轨迹数据的隐秘战场
众多巨头越过现金流,大力推行本地Agent,这背后还有一层更为深远的战略意图,那就是争夺下一代大模型进化所需要的核心燃料,也就是任务轨迹数据。
历经过往几年,大模型竞争的关键所在是算力以及训练数据。然而在业内存在着一项共识情形:于互联网之上高质量的公开文本,诸如维基、新闻、论文这些,已然是被各家模型近乎摄取殆尽。若是持续仅投喂这般静态文本,大模型仅仅是会演变成一个更具学识的“书呆子”,可是却无法迈进真正能够付诸行动的AGI门槛。下一代模型所需求的,乃是人类于数字世界之中“如何做事”的数据,也就是所谓的“任务轨迹数据”。
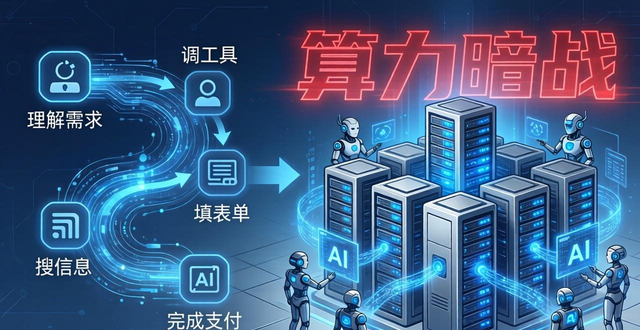
这种数据所记录的,是一条完整的任务链路,它起始于理解需求,接着是搜信息,然后是调工具、填表单、最后完成支付,每一步都会留下相应痕迹。对于训练Agent模型而言,这种数据相较于普通文本,其价值要高得多,原因在于它所反映的是现实世界当中的行动逻辑以及因果推理。而这一点,恰恰是过去巨头们最难获取到的数据,它们隐匿于无数个相互割裂的软件、封闭的App以及企业内网的深处,即便搜索引擎的爬虫能力再强,也无法将其爬取到。
在用户终端所部署的OpenClaw,乃是深入那些数据领地的“探测设备”。你要是叫Agent替你去进行操作,它会忠诚地记录下每一项操作意图以及软件交互行径。更为关键之处在于,你于指导它以及纠正它错误的进程里面,实际上是在无偿为厂商给予最为优质的强化学习数据。OpenClaw中国社区经理Alan Feng讲得颇为实在:“用户安装完毕后往往盼望着如魔法般的自动化,然而真正的价值在于定义明晰的任务。”。轨迹数据给出反馈,能够促使模型持续优化,如此一来,厂商方才可以不断提升代理能力。
这场呈现分布式特点的“数据众包”,其与特斯拉借助几百万辆电动车收集路况数据进而反哺FSD算法的逻辑一模一样。阿里Qwen项目的一位身处内部的人士也坦白表示:“中国在领先新范式方面的概率低于20%,不过凭借Agent轨迹数据,能够迅速迭代模型、缩近距离。”谁获取到数量最多的轨迹数据,谁便能够率先训练出真正具备“长出手脚”能力的超级模型。
OpenClaw是一个在全球范围内存在的开源项目,然而其在中国所拥有的热度,要远远超过其他的市场,这并非仅仅只是偶然情况。中国存在着全球最大的开发者社区当中的其中一个,对于开源工具而言,其接受程度以及传播速度极其之快。更为关键重要的是,中国的大模型生态造就形成了一种独具特色的“低价API”格局,即国产模型的API调用价格,大概是海外相同类型产品的六分之一。在这背后,存在着国内推理算力成本方面的结构性优势,其中含有更为便宜的电力,具备更灵活的硬件配置,有的厂商在进行推理时甚至使用消费级的5090显卡,并且还存在着模型厂商之间激烈的价格战。
该种低成本架构,致使OpenClaw于中国的运转开销远远低于境外,而且还吸引了众多使用者蜂拥而入。当处在那种部署成本几近为零的状况里,普通民众对于错失人工智能发展大潮流的焦急心情被完全点燃起来。从深圳公务员那儿的“龙虾上线”开始,一直到抖音平台上形成全民刷屏的态势,OpenClaw的传播途径已然跨越了技术领域范畴,进而演化为一场涵盖全社会方方面面的AI启蒙活动,将公众的认识从“AI搜索”的境界推向了“Agent执行”的层面。
与此同时,国产模型的“Token出海”速度正在加快。OpenRouter最新给出的数据表明,国产模型的Token消耗所占的比例,已然自2024年末的2%急剧飙升到了39%。出海所采取的策略并非依靠海外的基础设施,而是将推理算力留存于中国,选择走蒸馏数据以及低价API的路线——推理对于带宽的要求并不高,延迟方面的感知也并不显著。这样一种“算力在国内、服务在全球”的模式,正使得中国AI产业链于全球Token市场里占据着愈发重要的地位。
“推理2.0”:GPU与CPU的架构重构
要是讲OpenClaw于应用层面掀起了一回Agent风暴,那么它于底层硬件架构上所引发的冲击波同样十分剧猛。问题的关键之处在于:传统GPU的设计思路乃是针对“训练”开展优化的——谋求大规模并行计算,还有高显存带宽以及集群互联能力这几方面。可Agentic AI的推理负载,跟训练全然不一样:它呈现出的情况为高并发、小批量以及持续运行。Agent并非一次性去吞吐海量数据,而是持续不断地接收小请求,接着做出小决策,再调用外部工具,之后等待反馈,随后才进入到新一轮的推理过程当中。这种呈现为“碎片化推理”样态的模式 ,致使GPU于高并发场景当中无法实现满负荷运行 ,其运行效率仅处于20%至50%的区间 ,存在着极为严重的算力浪费情况。
很明显,英伟达已然察觉到了这个结构性的缺口,在2026年的时候,该公司花费了200亿美元,收购了Groq的核心资产,获取了LPU和TSP推理架构的非独家技术授权,并且还带走了Groq创始人Jonathan Ross(TPU之父),以及约90%的核心团队,要是说GPU是“通用高性能AI工厂”,那么LPU就是“为推理产线定制的流水线”。英伟达在Agentic AI时代,补齐推理性价比短板的战略武器是引入LPU,它会在推理领域,和各种ASIC芯片进行正面竞争。
有一个值得予以关注的信号,它就是英伟达的Vera CPU平台。在官方文档当中,Vera被界定为“用于agentic推理的数据引擎”,并非传统意义的Host CPU。它存在一个设计目标,此目标为“让GPU始终保持满负荷运转状态”,它还强绑定于KV Cache管理、工作流编排、AI工厂控制平面对应的这些Agentic AI特有的新型负载之上。在2026年2月的那次合作公告之中,Meta透露了这样的情况,双方已然是在着手推进大规模Grace-only的部署工作,并且在合作推进Vera CPU的潜在大规模部署事宜。这所蕴含的意义就是,在了Agent时代这个阶段,CPU并非仅仅只是GPU的附庸这么简单了,而是摇身一变成为了推理流水线里独立承担着调度以及数据流转任务的关键节点。
相较于宏观视角而言,英伟达每次所推出的新产品,皆是因当下既有产品无法精准覆盖新生需求所致。从借助HBM解决高显存需求,到凭借十万卡集群达成训练规模,到动用NVL来回应开发者编译需求,再至借由CPX架构实现推理的PD分离——每一次的迭代均在确认一个全新的需求方向。而在2026年至2027年这段时间内最大的新生需求,恰恰是由OpenClaw所掀起的Agentic AI浪潮。由LPU与Vera所组的合组,标明芯片产业正式踏入“推理2.0所表示的那个时代时段了,它是这样演变的——此演变是从一心追求峰值运算能力,转变为一心追求推理吞吐的那种极致效率表现了。
“入口战争”的第四次轮回
回顾往昔中国互联网那颇为繁杂曲折的历程,每一回技术范式所产生的显著跃迁,皆是伴随着一场围绕入口展开的激烈战争。在门户时代,各方为争取首页流量而展开了诸多角逐,到了搜索时代,百度摇身一变成为了信息的重要入口,步入移动互联网时代,微信、支付宝以及抖音则成为了极具影响力的超级App。如今,AI Agent正着手开启第四次轮回,这般状况。
和代理型人工智能之间存在着核心区别的传统人工智能,(@心智观察所制图)
阿里千问推出“AI办事”功能,使用者仅用一句话便能够下单;小米将MiclawAgent植入手机底层系统,意图使手机、汽车、电视以及家电皆成为AI的执行节点。这些举措传达出一环清晰的信号:未来,用户与数字世界的交互界面,将会被完全重构。当你习于以一句话表述需求,操作路径旋即会发生根本性改变——你不会再主动开启某个App,而是把任务交予AI,由AI抉择使用哪个平台、调用哪项服务、经由哪条支付链路。App依旧存在,然而已然退化为服务节点,真正的入口,乃是那个协助你完成任务的Agent。
那种进一步深入层次的博弈,关键之处在于‘意图分发权’。要是巨头能够促使自家的Agent去占据用户的终端,那么它便掌控住了商业领域里最为顶级层面的权力 ,这权力是能够将外卖订单向着有联系的企业进行引导 ,还能够把差旅方面的需求朝着自身的支付生态予以导向。在这个借助Agent构建而成的全新的‘围墙花园’境地当中 ,曾经横霸一时的超级App ,极有可能会沦落成为仅仅是提供底层服务接口的‘管道’ ,从而丧失掉与用户直接进行对话的契机 ,并且也会失去品牌方面的溢价以及流量方面的溢价。这便是为何大厂对于Agent这般敏感,所有人都期望成为那个掌控Agent的平台。
依照技术史而言,每一回平台级别的变动,通常皆是起始于一个毫不起眼的开端,Android最初仅仅是极客用于刷机的系统,微信公众号刚问世之际不过是个简易的内容工具,小程序推出之时愈发像是一个轻量级网页。然而它们后续均演变成了全新平台。OpenClaw现今所处的状况,与这些早期产品存在着令人惊谔的相似之处——它看上去依旧粗糙、不稳定,尚需用户手动进行纠错,不过它所代表的方向已然无法逆转:AI正从“会说话的工具”转变为“会做事的系统”。
这场变革之中,投资主线正渐渐明晰,那便是云部署基础设施予以扩张,推理算力硬件进行迭代,国产AI芯片加快适配进程,端侧设备实现智能化升级,应用集成生态予以重构,以及AI安全体系得以建立。上游MaaS业务出现爆发态势,致使算力供给明显供不应求,拿卡能力以及能耗指标,已然成为竞争力的关键衡量标准。
在中国这里,OpenClaw风暴其深层次包含的意义,是在全社会这个层面全方位上的AI方面达成了认知往更深层次跃进,是那种大模型由原本的比谁相较于谁来说看上去更具聪明程度进入到比谁能够切实去做事情的一个具有转折意义的分界点,是算力方面投入情况中之前囤着备用但不加以使用转变为持续不断实现价值转化的一个关键转折点,还是芯片架构上从以注重训练排首位置转变为以推理作为首要考量的一种信号指示方面的内容。当几百万数量的Agent在全球范围之内的电脑以及手机上面没日没夜不间断地消耗Token、收集相关轨道路径、执行相应任务,我们此时面对的状况,并非仅仅只是一个新工具在流行传播这么简单,而是整个数字世界运行所依据的逻辑进行了一次深度层面的重新书写。
正在经历的中国互联网,或许恰恰就是这场风暴的前夜,而一旦风暴来临,没有任何人能够置身于其外。
本文采摘于网络,不代表本站立场,转载联系作者并注明出处:https://mjgaz.cn/fenxiang/280072.html

